مجموعهداده تصاویر خودروهای ایرانی برای الگوریتم تشخیص شیء
یک مجموعهداده بومی شامل ۳۰۰۰ تصویر خودرو و ۵۷۶۵ باکس برچسبگذاریشده که عملکرد YOLOv8s را نسبت به مدل آموزشدیده با COCO بهطور محسوسی بهبود داد.
تصاویر و نتایج پژوهش
1 تصویر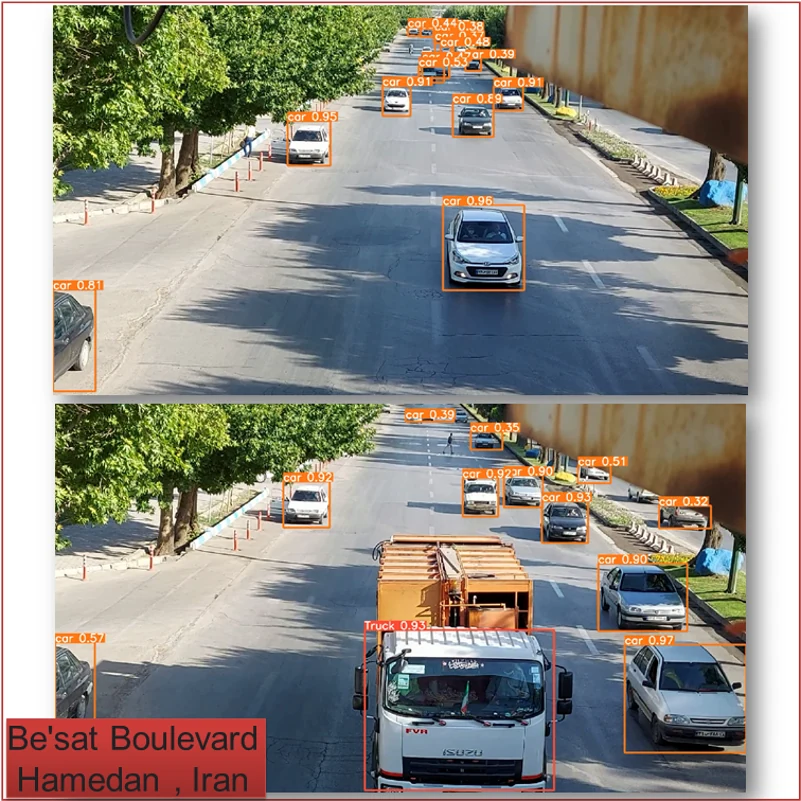
کیفیت یک سامانه تشخیص شیء تا حد زیادی به کیفیت و مرتبطبودن دادههای آموزشی وابسته است. در این پژوهش بهجای اتکا صرف به دیتاستهای عمومی، یک مجموعهداده اختصاصی برای شرایط واقعی ترافیک شهری ایران تهیه شد.
چرا دیتاست بومی اهمیت دارد؟
توزیع برندها، مدلها، زاویه دید و شرایط تصویری خودروها در ایران با بسیاری از دیتاستهای عمومی متفاوت است. یک مدل عمومی ممکن است در بنچمارکها عملکرد خوبی داشته باشد، اما در محیط محلی دچار افت شود. به همین دلیل تصاویر از منابع ایرانی جمعآوری و بهصورت دستی برچسبگذاری شدند.
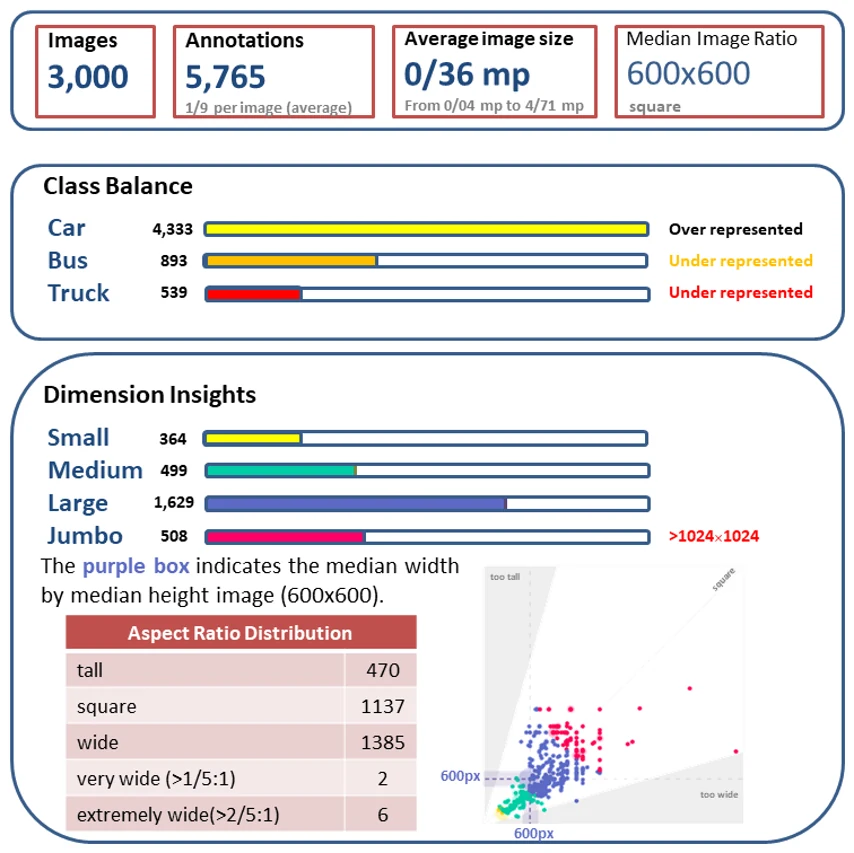
مشخصات مجموعهداده
- ۳۰۰۰ تصویر
- ۵۷۶۵ باکس برچسبگذاریشده
- سه کلاس: خودرو، اتوبوس و کامیون
- استفاده از تصاویر منابعی مانند دیوار، باما و صحنههای ترافیکی
- تنوع مناسب در زاویه دید خودروها
- تفکیک دادهها به آموزش، اعتبارسنجی و آزمون مستقل
نتایج YOLOv8s
مدل YOLOv8s آموزشدیده با این دیتاست به دقت ۹۱٫۷٪ و mAP@0.5 برابر ۹۲٫۶٪ رسید. مقایسه با مدل مبتنی بر COCO نشان داد آموزش دامنهمحور میتواند کیفیت تشخیص را بهشکل محسوسی افزایش دهد.
| معیار | نتیجه دیتاست اختصاصی |
|---|---|
| Precision | ۹۱٫۷٪ |
| Recall | ۸۶٫۶٪ |
| mAP@0.5 | ۹۲٫۶٪ |
| mAP@0.5:0.95 | ۷۰٫۲٪ |
نکته مهندسی
نتیجه مهم این پروژه این است که داده بهتر گاهی از مدل پیچیدهتر ارزشمندتر است. جمعآوری هدفمند، برچسبگذاری دقیق، تحلیل توزیع کلاسها و افزایش داده میتواند یک معماری موجود را برای کاربرد واقعی بسیار مؤثرتر کند.
نمونه ساده فرایند آموزش
pythonfrom ultralytics import YOLO model = YOLO("yolov8s.pt") model.train( data="iranian-vehicles.yaml", imgsz=800, epochs=100, lr0=0.01, )
این مجموعهداده میتواند در سامانههای حملونقل هوشمند، پایش ترافیک و تحقیقات آینده در تشخیص خودروهای بومی مورد استفاده قرار گیرد.