سیستم هوشمند کنترل چراغ راهنمایی با استفاده از شبکههای عصبی عمیق
پایاننامه کارشناسی ارشد من در سال ۱۴۰۰ از یادگیری تقویتی با Deep Q-Learning، شبیهساز SUMO و تخمین ترافیک مبتنی بر YOLO برای کنترل تطبیقی چراغ راهنمایی استفاده کرد.
تصاویر و نتایج پژوهش
2 تصویر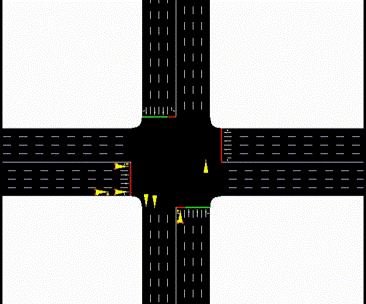
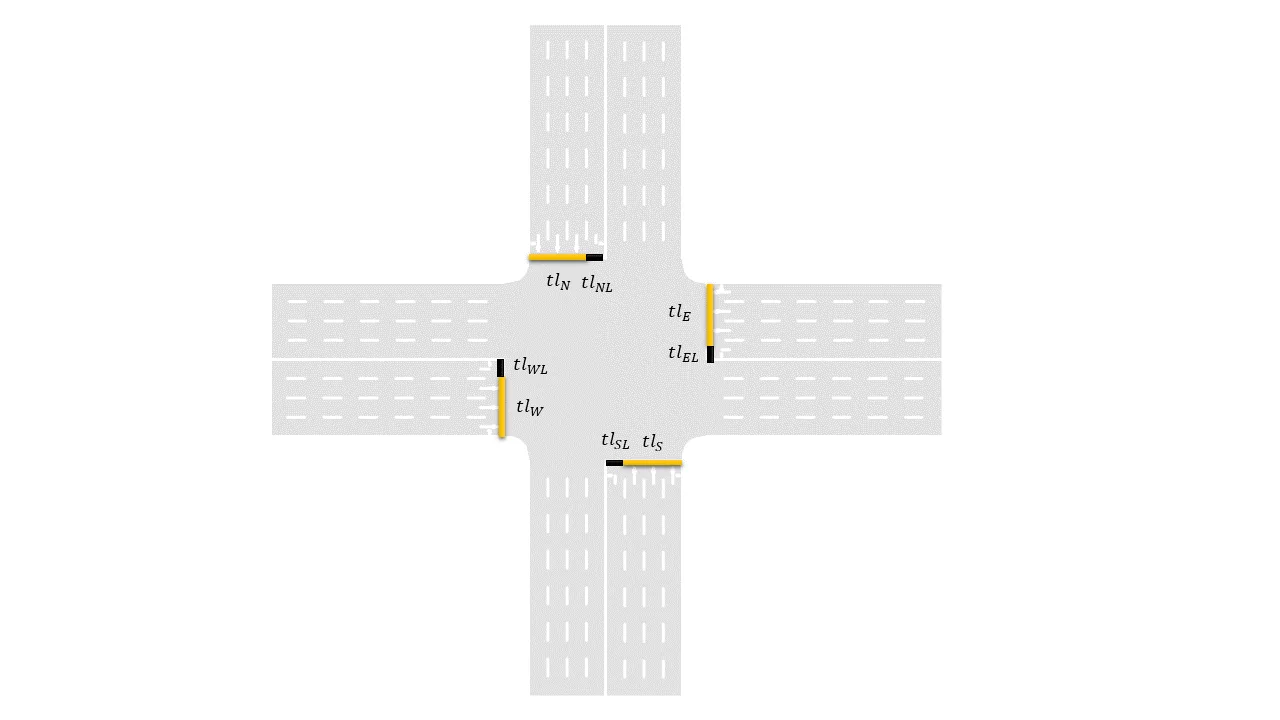
چراغهای راهنمایی کلاسیک معمولاً بر اساس زمانبندی ثابت یا قوانین از پیش تنظیمشده کار میکنند. در پایاننامه کارشناسی ارشد من ایدهای تطبیقیتر بررسی شد: چهارراه بهعنوان یک محیط یادگیری تقویتی مدل شود و عامل هوشمند یاد بگیرد چه تصمیمی باعث کاهش تراکم و تأخیر میشود.
حلقه یادگیری
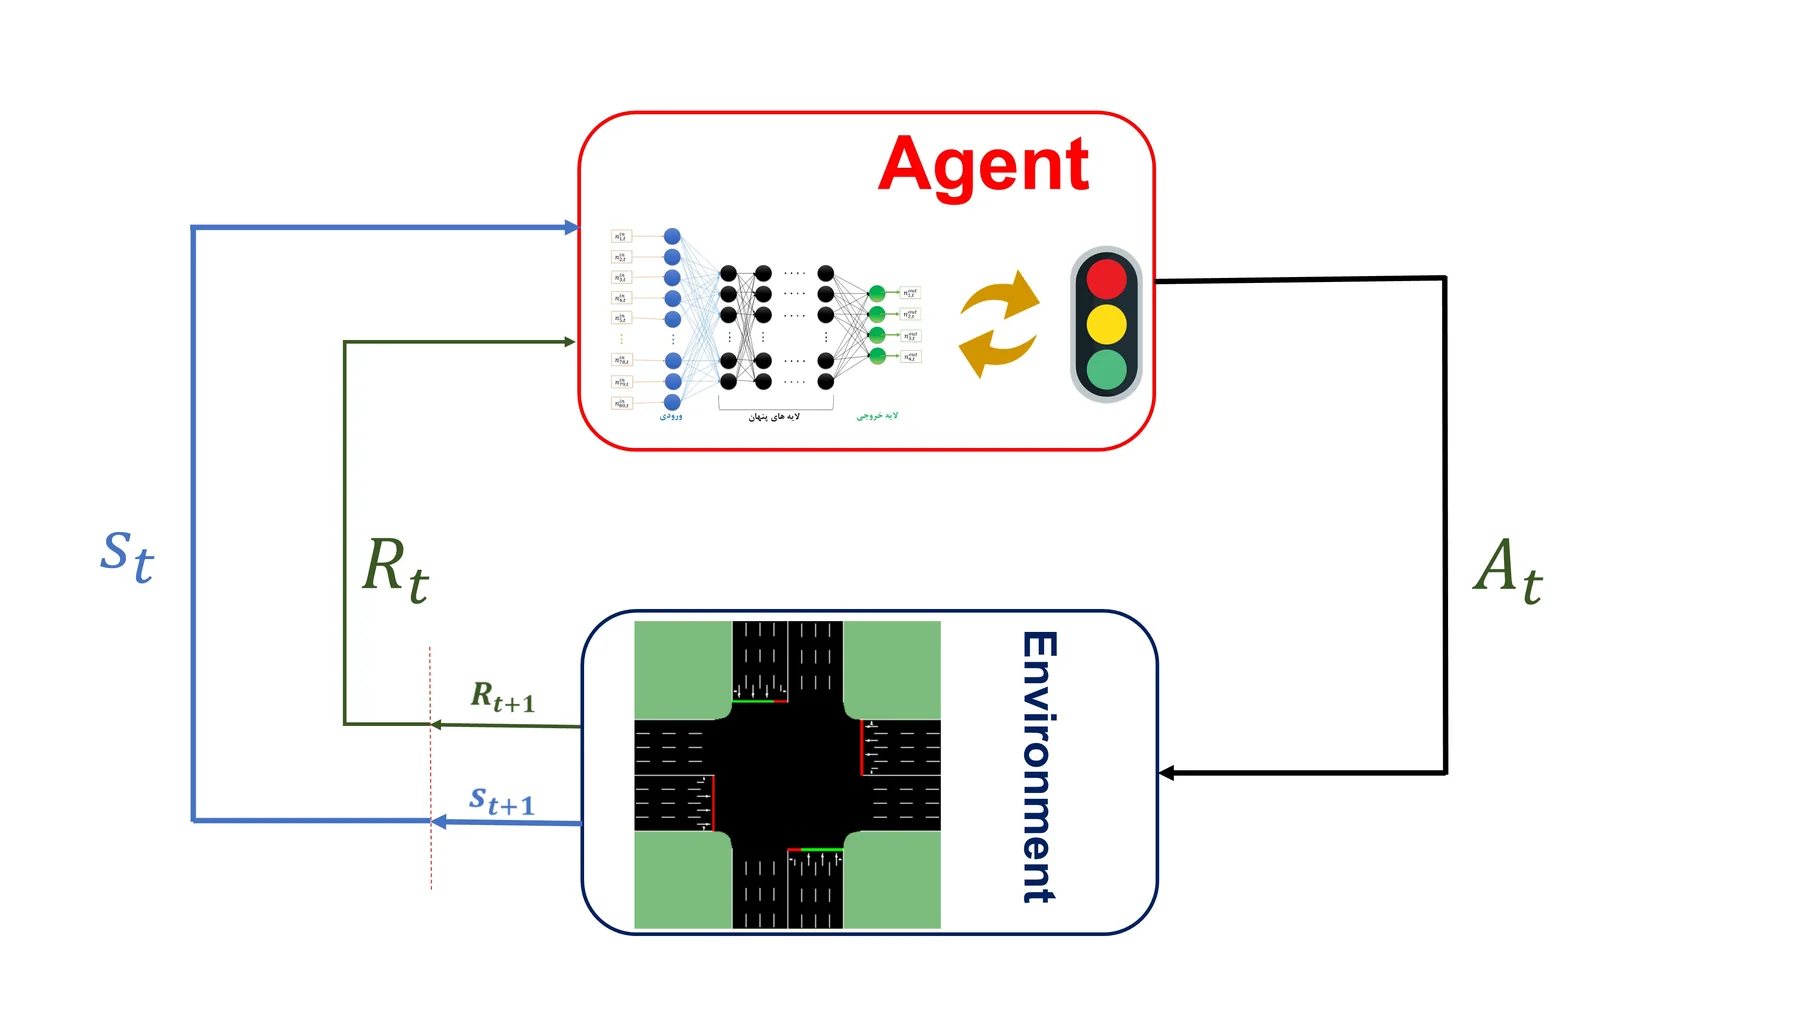
محیط ترافیک با SUMO شبیهسازی شد. در هر مرحله تصمیمگیری، عامل وضعیت فعلی ترافیک را دریافت میکرد، یک فاز چراغ را انتخاب میکرد و سپس پاداشی متناسب با عملکرد ترافیک دریافت میشد.
textوضعیت ترافیک ← عامل Deep Q-Learning ← فاز چراغ ↑ ↓ └──────── پاداش / تأخیر ───────┘
اتصال بینایی ماشین
یک کنترلکننده تطبیقی واقعی به تخمین قابل اعتماد از تراکم خودرو نیاز دارد. به همین دلیل پردازش ویدئوی بلادرنگ و تشخیص خودرو با YOLO بهعنوان لایه ادراک بررسی شد.
معماری کلی به این صورت است:
- دوربین چهارراه را مشاهده میکند
- آشکارساز تعداد و تراکم خودروها را تخمین میزند
- وضعیت به عامل RL ارسال میشود
- عامل فرمان چراغ بعدی را انتخاب میکند
- محیط، وضعیت و پاداش جدید ایجاد میکند
چرا یادگیری تقویتی برای ترافیک مناسب است؟
ترافیک ماهیتی تصادفی و پویا دارد. تصمیم بهینه فقط به صف فعلی وابسته نیست، بلکه باید اثر تصمیم فعلی بر تراکم آینده را هم در نظر بگیرد. یادگیری تقویتی برای چنین مسئله تصمیمگیری دنبالهای بسیار مناسب است.
بینش قابل انتقال
مهمترین دستاورد این پایاننامه برای من، تجربه ترکیب مدلسازی ریاضی، شبیهسازی، ادراک و بهینهسازی دنبالهای در یک سیستم مهندسی بود؛ الگویی که در رباتیک، تخصیص منابع و بسیاری از کاربردهای بلادرنگ هوش مصنوعی نیز تکرار میشود.