تحلیل ریسک سیلاب با یادگیری عمیق
مقایسه سه روش یادگیری ماشین برای پیشبینی امتیاز مواجهه، بحرانیبودن و ریسک سیلاب با استفاده از دادههای ۲۶۳۴ پل.
تصاویر و نتایج پژوهش
1 تصویر
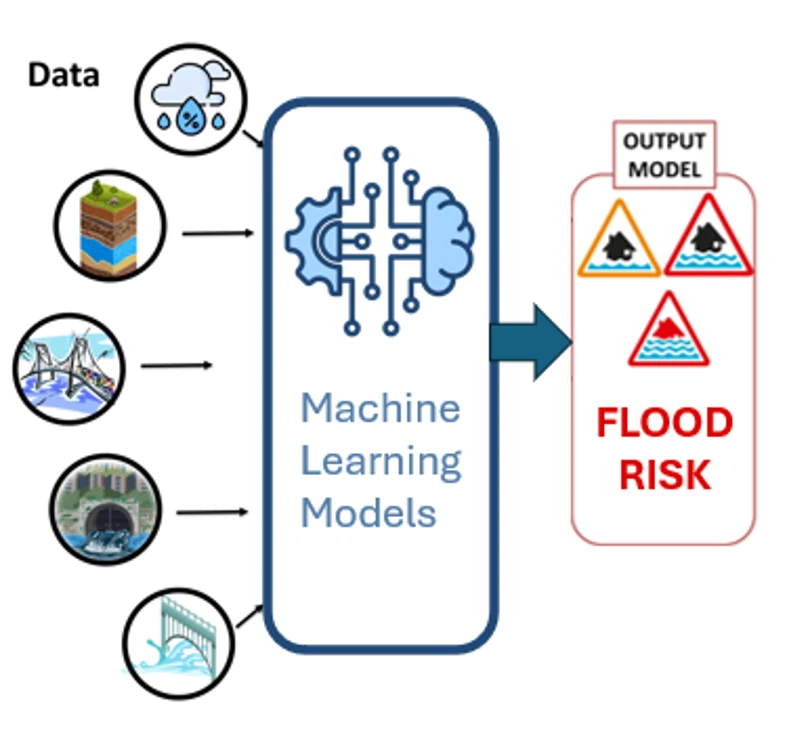
برنامهریزی برای ریسک سیلاب در اصل یک مسئله پیشبینی در شرایط عدمقطعیت است. در این پژوهش سه رویکرد Random Forest، LSTM و SVM برای تخمین ریسک مرتبط با زیرساخت بررسی شدند.
مدلسازی ریسک
تحلیل بر پایه ۲۶۳۴ رکورد مربوط به پلها انجام شد. ریسک به دو مؤلفه اصلی تقسیم شده است:
- Exposure یا میزان مواجهه با عوامل محیطی و خطر
- Criticality یا میزان اهمیت و آسیبپذیری زیرساخت
سپس این دو مؤلفه برای محاسبه امتیاز نهایی ریسک ترکیب میشوند.
مقایسه مدلها
برای پیشبینی Exposure، مدل Random Forest کمترین خطا را داشت (MAE=0.41 و MSE=0.25). برای Criticality نیز بهترین بود (MAE=0.38 و MSE=0.11). در پیشبینی امتیاز نهایی ریسک، LSTM بهترین نتیجه را ثبت کرد (MAE=0.31 و MSE=0.11).
| هدف | بهترین مدل | MAE | MSE |
|---|---|---|---|
| Exposure | Random Forest | 0.41 | 0.25 |
| Criticality | Random Forest | 0.38 | 0.11 |
| Risk | LSTM | 0.31 | 0.11 |
چرا مدلهای مختلف برنده شدند؟
Random Forest برای روابط غیرخطی در دادههای جدولی بسیار مناسب است و معمولاً بدون پیشپردازش سنگین عملکرد پایداری دارد. LSTM نیز در ساختارهایی که وابستگی ترتیبی یا پیوستگی میان دادهها وجود دارد مزیت دارد.
نکته مهندسی مهم این است که یک «بهترین مدل عمومی» وجود ندارد؛ انتخاب مدل باید با ساختار مسئله و نوع خطای مهم در کاربرد واقعی هماهنگ باشد.
کاربرد
تخمین دقیقتر ریسک سیلاب میتواند به اولویتبندی اقدامات مقاومسازی، برنامهریزی زیرساخت و تصمیمگیری بهتر در مدیریت بحران کمک کند.